中美医疗大模型评测机制差异--中国用“题海战术考AI医生,美国相信“实战”出真知
一个事实:中国MedBench已升级至5.0——近100万条专业评测试题、63项细分临床评测任务,还首次开设了由院士团队共建的专科挑战赛;而美国OpenAI的HealthBench仅有5000例开放对话,却动用了262位全球临床医生逐条手写评分标准。
一个边界:但MedBench的题库由上海AI实验室联合医学机构自主构建,HealthBench的每段对话都按真实医患场景设计、评分标准由医师逐条撰写——两套体系的核心假设完全不同。
一个判断:医疗AI评测正在分裂为"题海量派"与"精兵实战派"两条路线,尽管二者已经开始互相渗透。这直接决定了AI进入医院的方式,也决定了你未来面对的"AI医生"到底是考试机器还是临床助手。
一、中国路线:MedBench,国家队的"题海战术"
MedBench由上海人工智能实验室联合上海市数字医学创新中心推出,是国内首个面向中文医疗大模型的标准化评测平台,已纳入司南大模型开源开放评测体系(OpenCompass)。
2025年11月发布的MedBench 4.0,覆盖60个全自主构建评测集,共70万余专业评测题。2026年8月,MedBench进一步升级至5.0:依托近100万条专业评测试题,覆盖63项细分临床评测任务,并首次开设专科专精赛道——8大专科挑战赛由钟南山、葛均波、范先群等院士团队参与共建。截至2024年7月,已有387个医疗大模型在此接受评测,这一数字至今仍在增长。
它的评测维度设计得很全:医学语言理解(MLU)、医学语言生成(MLG)、医学知识问答(MKQA)、复杂医学推理(CMR)、医疗安全与伦理(HSE)。
最狠的是防作弊机制。MedBench采用"循环洗牌"随机重排选项顺序,配合"随机提示匹配"从无关提示池中抽取干扰项,防止模型靠记忆或选项顺序猜答案;题库持续动态更新,让"背题"越来越难以奏效。
这套逻辑很清晰:用足够大的题量、足够密的维度、足够严的防作弊,筛出真正懂医学知识的模型。
二、美国路线:没有"美国的MedBench",只有一群"精兵"
美国没有一家机构能一统医疗AI评测江湖。取而代之的是三条并行战线,各自解决不同层面的问题。
第一层:OpenAI HealthBench——考"对话",不考"做题"
2025年5月,OpenAI发布了HealthBench,这是目前美国最具影响力的医疗AI开放评测基准。它完全不走"医学考试"路线,而是设计了5000段按真实医患场景构建的多轮临床对话,由262位来自60个国家的临床医生逐条制定评分标准。
评分不是简单的对错,而是按五个行为轴打分:准确性、完整性、沟通质量、情境感知、指令遵循。
HealthBench还分了两个子集:Consensus(专家共识验证项)和Hard(高难度挑战项)。Hard子集专门挑那些会让模型得零分或输出不安全内容的病例。
2026年8月的最新排行榜显示,即使是顶尖模型,在Hard子集上的最高分也只有42.8%(Meta的Muse Spark),GPT-5.4为40.1%
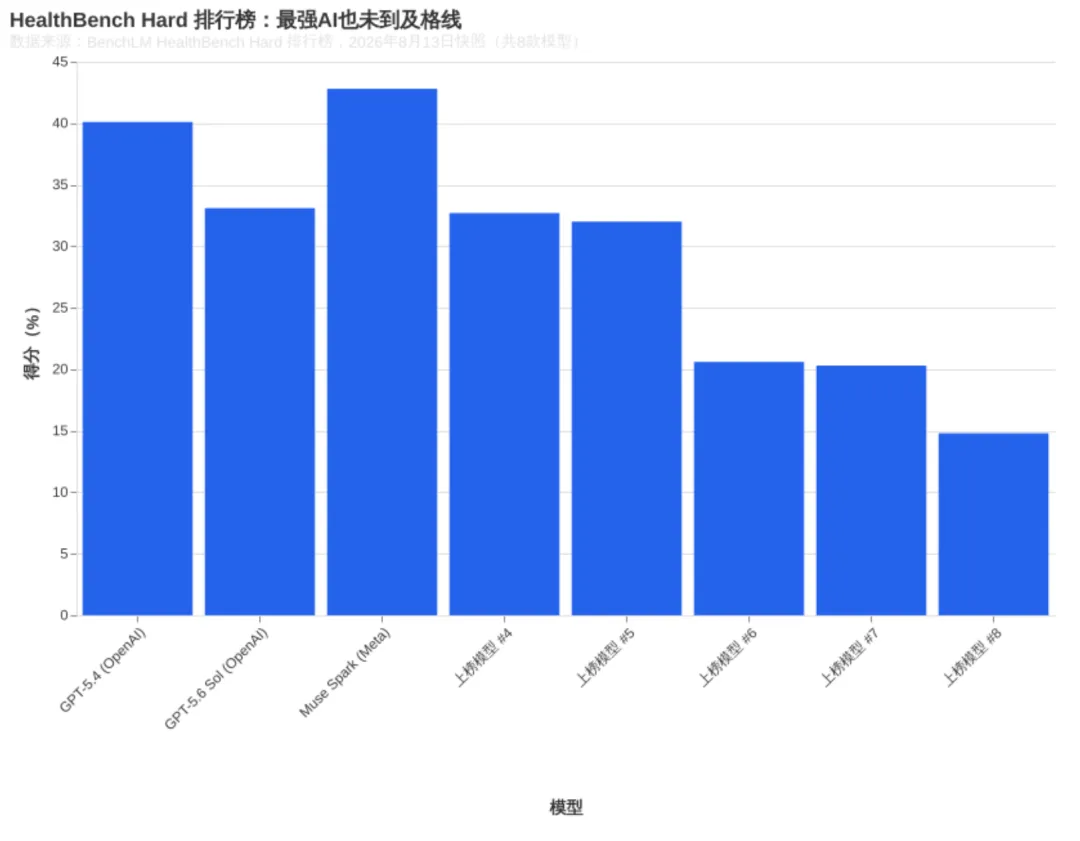
这意味着什么?当前最强的AI,在最困难的医疗对话场景中,连及格线都摸不到。
第二层:斯坦福MedAgentBench——考"干活",不考"聊天"
如果说HealthBench考的是"你会不会跟病人说话",那斯坦福发表在《NEJM AI》(《新英格兰医学杂志》旗下专注于人工智能与医学交叉领域的独立姊妹刊)上的MedAgentBench考的就是"你会不会在医院系统里干活"。
MedAgentBench搭建了一个FHIR(快速医疗互操作资源,国际通用的医疗数据交换标准)兼容的虚拟电子病历环境,里面有100个患者档案、70万+数据元素。模型需要完成300个真实临床任务:开药、下检查单、调阅病历、写病程记录。
该研究2025年发表时,最佳成绩是Claude 3.5 Sonnet v2的69.67%——近三成任务会失败。斯坦福团队表示,更新的模型成功率已明显提升,但距离"零失误"仍然很远。
这项研究揭露了一个关键盲区:模型在MedQA(美国医师执照考试风格的题库)上的得分已接近天花板,但在MedAgentBench上连70%的任务都完成不了。知识考满分,不等于会看病。
第三层:FDA的盲区:批了1451个AI,却零横向对比
1、FDA本身不是评测机构,但它的AI/ML医疗设备清单正在塑造行业的"及格线"。截至2025年底,FDA已累计批准1451个AI/ML医疗设备,2025年单年就批了295个,创历史新高。但这里有一个巨大的证据缺口:2025年《JAMA Health Forum》审阅了691个FDA已批准AI设备的审批档案,结果触目惊心:46.7%的摘要没写研究设计,53.3%没报告样本量,不到2%引用了随机对照临床试验(RCT)——这是医学证据的"高考",能证明"是这个AI导致了好的结果"而不是巧合。
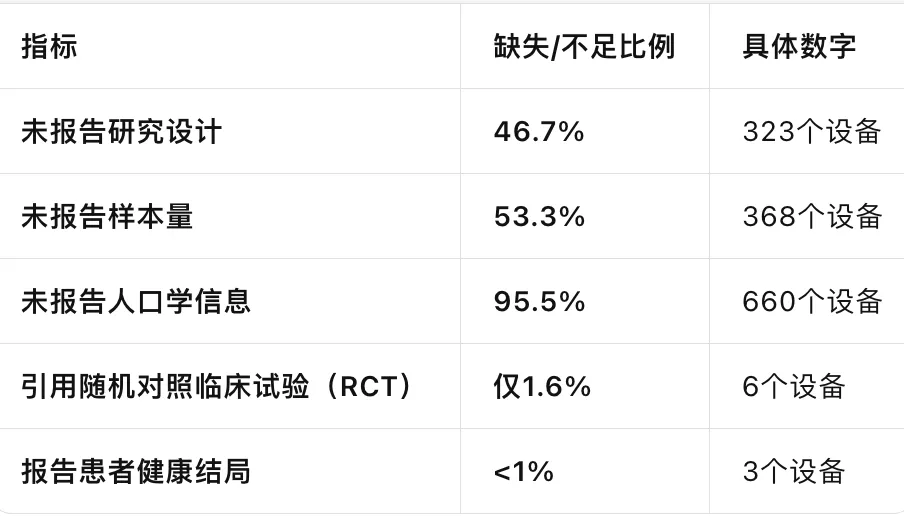
也就是说:近一半厂商连"我们怎么测的"都没交代,超过一半连"测了多少人"都没说。 这意味着,那个被FDA盖章的AI读片工具,可能只是在一家医院、用几百张精心挑选的片子做了回顾性回测,就拿到了上市许可。FDA的审批门槛,在证据质量上可能比你想象的要低得多。
2、更值得注意的是通用大模型的"越界"。 2026年6月《Nature Medicine》的一项研究用MedQA(美国医师执照考试基准)和HealthBench(OpenAI医疗对话评测基准)对比测试发现,GPT-5.2(OpenAI通用大模型)、Gemini 3.1 Pro(谷歌通用大模型)等通用大模型的表现,优于两款面向医生的专科临床AI工具——OpenEvidence(临床决策支持工具)和UpToDate Expert AI(循证医学临床参考工具)(注意:这两款是临床参考工具,并非FDA获批器械)。
但这个结论本身还在被争夺,而且原因可能比"谁更聪明"更复杂。
论文作者自己给出了几个可能的解释:
第一,RAG(检索增强生成)反噬。OpenEvidence和UpToDate Expert AI都高度依赖RAG——从医学文献库中检索相关内容再生成回答。但已有研究表明,当检索到不相关材料,或基础模型整合检索结果的能力不足时,RAG反而会损害输出质量。换句话说,"查资料再回答"这个设计,在部分场景下成了拖累。
第二,通用模型在"沟通"维度上全面碾压。在HealthBench的五个评分轴中,通用模型在完整性、沟通质量、情境感知三个维度上显著领先。OpenEvidence在清晰度维度上得分最低(2.84分),说明它的短板不是"不懂医学",而是"不会把医学知识组织成医生能读懂的回答"。
第三,专业工具"拒答"率过高。 在真实临床查询(RCQ)测试中,UpToDate AI拒绝了19%的查询,而其他模型仅拒绝1-3%。拒绝率过高等于直接交白卷——这在评分中是大忌。
第四,评测基准本身可能有偏差。 MedQA和HealthBench是公开数据集,通用大模型在训练时可能"刷过题"(数据污染)。更微妙的是,HealthBench由OpenAI开发,GPT-5.2在其上得分最高,可能存在"基准-开发者重叠"——训练数据、优化目标或评分标准设计上的隐性偏向。但作者强调,RCQ(真实临床查询)基准完全来自NYU Langone医院的真实去标识化查询,不受训练数据污染,而在这个基准上通用模型仍然胜出。
第五,也是最关键的一层:通用模型在"规模、对齐和跨域推理"上的投入,可能已经超过了专业工具的"医学专项优化"。 论文指出,前沿LLM拥有更大的训练语料、更快的迭代周期和更强的对齐能力,"规模、对齐和跨域推理可能超过领域特定调优,成为医学能力的关键决定因素"。
不过作者也给自己留了退路:这只是一个"快速演变格局的快照",不是永久排序。深度专科任务可能仍需要更复杂的领域适配。而且这项研究没有评估响应延迟和引用质量——这两点恰恰是专业工具在真实临床中的核心优势。
这个结论仍在被反向争夺:OpenEvidence资助的一项独立研究得出了相反结果;另一项来自Synduct(医疗AI公司)的预印本研究也显示,其专科医疗系统在HealthBench Hard(高难度医疗对话评测集)上反超了GPT-5.2。
所以更准确的说法是:在"知识问答"和"对话对齐"这两个维度上,通用大模型目前确实更强;但在"引用可追溯性"和"响应速度"这两个维度上,论文没测,专业工具未必输。 这场争论的本质,其实是"考试考什么"决定了"谁拿高分"。而FDA的审批体系,恰恰不考这场试——它只问"你是否达到了自己声明的性能",不问"你是否比通用大模型更强"。
三、核心分歧:考什么?怎么考?谁来判卷?
把两套体系放在一起看,差异一目了然。
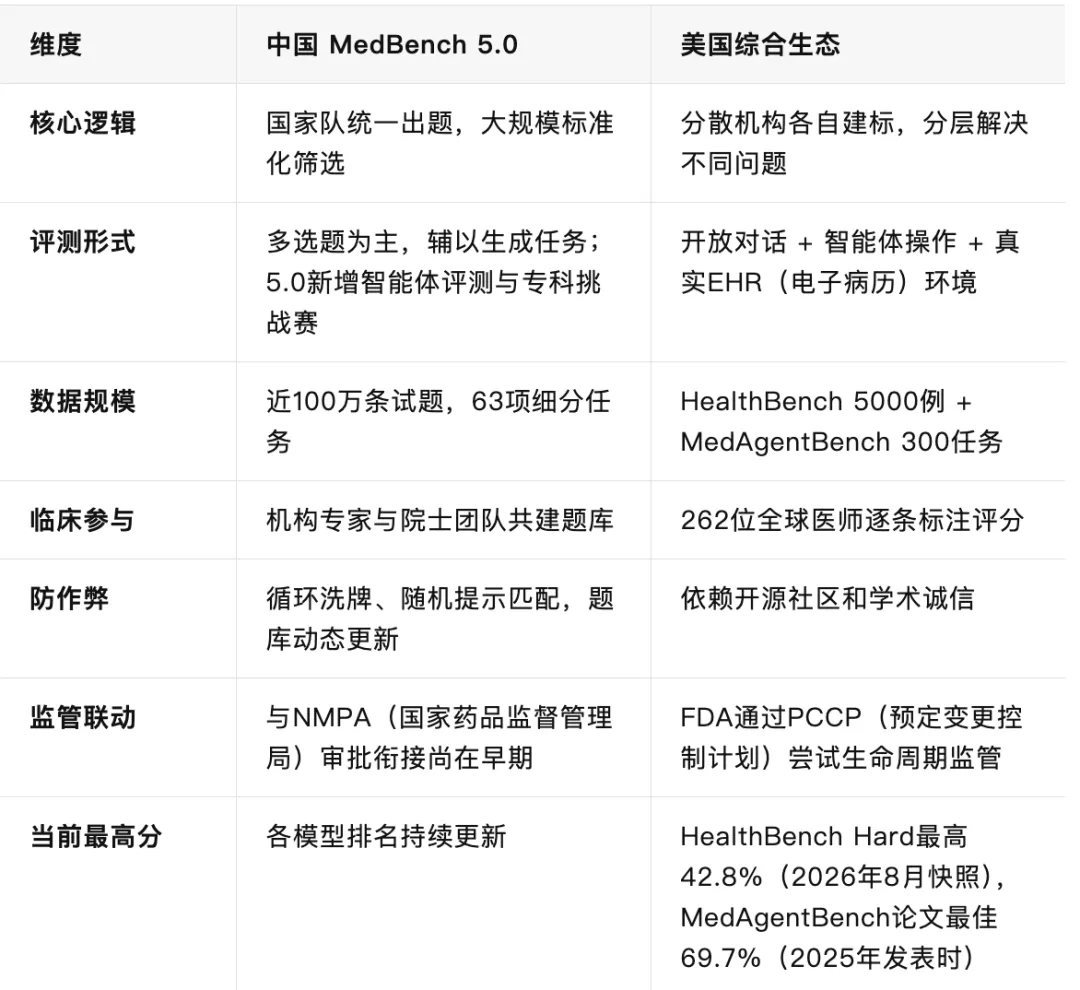
中国相信"题海"能筛出真才实学,美国相信"实战"才能暴露真问题。
需要说明的是,这条分界线正在变得模糊:MedBench从4.0起就引入了贴近真实诊疗的实战化评测,5.0更把智能体评测和专科挑战赛纳入核心框架——"中国只考做题"已经不完全成立。
MedBench的优势在于覆盖广、防作弊严、中文场景深。它的近100万道题能确保模型不会在医学常识上翻车,也能横向对比几百个模型的知识储备。
但HealthBench和MedAgentBench揭示了一个MedBench仍在补课的问题:医学知识 ≠ 临床能力。一个模型能在考试中拿高分,却可能在真实对话中遗漏关键病史、开出冲突药物、或者在病历系统里下错医嘱。
反过来,美国的分散生态也有代价。没有统一基准,厂商可以"挑考场"——在某个考试型基准上刷分就宣称"超越人类医生",在HealthBench上不提。FDA的审批更是只问"是否达到你自己声明的性能",不问"是否比通用大模型更好"。
四、对普通人的影响:你未来面对的AI医生,取决于这场"考试改革"
这场评测路线的分裂,最终会体现在你走进医院时的体验上。
如果"题海派"赢了,你面对的AI医生可能知识渊博、考试满分,但说话像教科书,问诊像做问卷,遇到复杂病例就卡壳。
如果"精兵派"赢了,你面对的AI医生可能对话流畅、能调病历、会开检查,但偶尔在基础医学知识上犯低级错误——因为没人用近100万道题筛过它。
但为什么中美一开始就走上了不同的路?
核心原因是两国的医疗体制和AI使命完全不同。中国医疗资源高度集中于三甲医院,基层(县级医院、乡镇卫生院)严重缺医生。AI医疗的首要任务是"知识下沉"——让偏远地区的医院也能达到三甲诊断水平。这要求AI首先具备扎实的医学知识,而不是复杂的对话能力。MedBench的70万道题,本质上是一个"国家级筛选漏斗":谁能做对足够多的题,谁就能被派去基层"补课"。
美国则相反。医疗市场化程度高,医生是绝对核心,AI只是辅助工具。它不需要替代医生的知识储备,而是必须融入医生的工作流——会调EHR、会写病程、会跟病人沟通。因此评测重心从"懂多少"(MedQA)进化到"会不会干活"(MedAgentBench)和"会不会说话"(HealthBench)。
第二个关键差异在监管逻辑。 中国NMPA(国家药监局)将所有AI医疗软件归为Class III(最高风险等级),审批最严,厂商需要可量化的性能指标(AUC、F1分数)才能过关。标准化题库提供了明确的"及格线"。而美国FDA将96%的AI设备归为Class II(中等风险),审批相对宽松,但上市后监管更严——这导致评测重心从"上市前考试"转向"上市后真实世界表现"。
第三个差异在数据生态。中国医院数据总量大,但跨机构共享困难(《数据安全法》《个人信息保护法》)。MedBench这样的集中式评测平台可以绕过数据孤岛——不需要把真实患者数据拿出来,用标准化题目就能横向对比几百个模型。而美国EHR系统极度碎片化(Epic、Cerner等互不兼容),没有全国统一的数据平台,很难建立大规模集中式题库,只能各机构在本地数据上各自验证,催生了分散式评测生态。
最可能的结果是:两条路线正在互相渗透。
五、一个值得警惕的信号
2025年,上海联影(United Imaging)拿下10个FDA AI/ML医疗设备clearance,成为当年全美获批最多的企业之一。截至2025年底,联影累计已有38个AI设备通过FDA审批,在国产品牌中遥遥领先。
这里需要先厘清一个概念:FDA的"clearance"不等于"approval"。
Clearance走的是510(k)实质等价通道——只要证明你的设备和市场上某款已上市设备"安全性和有效性实质等价",就能放行。这是FDA最宽松的审批路径,绝大多数AI影像软件都走这条道。
Approval走的是PMA(上市前批准)通道——针对心脏起搏器、人工心脏瓣膜等最高风险器械,必须自己做大规模临床试验,从零证明"我自己就是安全有效的"。
联影的10个AI设备,全部走的是clearance/510(k),不是approval/PMA。
这意味着什么?联影这些设备在中国上市前,面对的是NMPA(国家药监局)的严格审查,以及MedBench近100万道题的知识筛选;但到了美国,它们只需要找一个已上市的同类产品当"对标"(predicate device),证明"我的读片准确率和它差不多",就能通关。
注意:这里的"等价"绝不是知识产权层面的"抄袭"。 FDA审的是临床性能参数(灵敏度、特异度、AUC),不碰代码、算法和专利。联影的算法是自己写的,专利是自己的,它只是借用了FDA的监管"捷径"来快速入市。但通关之后,如果专利权人认为你的技术侵犯了他们的专利,美国联邦法院随时可以起诉你——FDA的clearance章,绝不等于"知识产权清白证明"。
更关键的是,同一个AI,在中国要考"近100万道题",在美国只要"对标一个已上市的同学"。FDA的510(k)逻辑是"你过线了吗",不是"你比谁强"。HealthBench不测影像AI,MedBench只测中文模型——两套评测体系像两条平行铁轨,永不相交。
结果是:一个中国患者和一个美国患者,可能用着同一款联影AI读片,但两人都不知道这款AI在对方国家的"考场"里表现如何。全球医疗AI评测分裂成孤岛,而患者站在岛上,看不见对岸。
【互动问题】
如果明天你去医院,挂号时被告知"这位AI助手通过了近100万道医学考题"和"这位AI助手在300个真实病历任务中成功率70%",你更信任哪一个?
A. 题海派——知识扎实才靠谱
B. 实战派——会干活比会考试重要
评论区聊聊你的选择 👇
信源清单
MedBench 官方平台,上海人工智能实验室。https://medbench.opencompass.org.cn/home
MedBench 5.0 发布报道(近100万条试题、63项细分任务、8大专科挑战赛),2026年8月。
MedBench 4.0 发布报道(60个全自主构建评测集、70万余题),浦江医学人工智能大会,2025年11月。
HealthBench: Evaluating Large Language Models Towards Improved Human Health,OpenAI,arXiv:2505.08775,2025年5月。
BenchLM HealthBench Hard 排行榜,2026年8月13日快照。https://benchlm.ai/benchmarks/healthbench-hard
MedAgentBench: A Virtual EHR Environment to Benchmark Medical LLM Agents,NEJM AI,斯坦福大学,2025年8月;及斯坦福HAI后续报道。
Lin et al.,Benefit-Risk Reporting for FDA-Cleared Artificial Intelligence–Enabled Medical Devices,JAMA Health Forum,2025年9月(691个设备、46.7%、53.3%、不足2%引用随机对照试验)。
Vishwanath et al.,General-purpose large language models outperform specialized clinical AI tools on medical benchmarks,Nature Medicine,2026年6月。
OpenEvidence backs study that finds it beats LLMs,STAT Health Tech,2026年7月(反向结论研究报道)。
Kumar et al.(Synduct),Evaluating an LLM-Based Medical Assistant on Realistic Clinical Queries,arXiv:2509.02594(2026年2月修订)。
2025 Year in Review: AI/ML Medical Device 510(k) Clearances,Innolitics,2025年12月(2025年295个、联影10个领跑)。
FDA AI/ML医疗设备官方清单及第三方统计(截至2025年12月30日,累计1451个)。
FDA,Request for Public Comment: Measuring and Evaluating AI-enabled Medical Device Performance in the Real-World,2025年9月30日。