医疗大模型系列之四:8亿人的健康入口,两起人命官司--OpenAI的规模红利与责任难题
一个事实:在将既有的“非正式健康入口”转化为“正式医疗产品”这件事上,OpenAI 可能是动作最迟的一家——尽管它手里的入口,比谁都大。截至2026年7月,ChatGPT上每周的健康相关提问已超过3亿次。
一个边界:同样是这家公司,正在被告上法庭。两起诉讼的原告主张(目前仍属诉讼中的事实主张,尚未经法院最终认定):ChatGPT曾向一名年轻人提供危险的药物混合建议,也曾对一位肺栓塞患者淡化症状、延误就医。无论判决结果如何,这两起案件已经把一个问题推到了台前:当AI以权威的语气给出健康建议,它在法律上算不算“行医”?
一个判断:评价OpenAI在医疗上的位置,不能只数它发了多少产品、签了哪家医院,更要看它给“医疗大模型”这个领域留下了什么——一套评测标准、一项真实世界证据、一个规模化入口,和一条刚刚起步的专用模型路线。但入口越大,责任边界也越难逃避。
2026年1月7日,OpenAI官宣ChatGPT Health,允许用户把病历、体检报告、Apple Health数据直接接入对话。五天后(1月12日),它宣布收购成立于2024年的医疗数据公司Torch——交易金额官方未披露,媒体报道介于6000万至1亿美元之间。而在此几个月前,它刚刚因为一起过量致死诉讼登上全美头条。一家公司在同一时期同时做这三件事——这本身就是理解OpenAI医疗战略最好的入口。
在系列前三篇里,我们拆解了医疗AI的底层逻辑(医疗大模型系列之一:医疗AI的底层逻辑,模仿、探索与智能涌现)、DeepMind的“屠龙刀”之路(医疗大模型系列之二:当AlphaGo的"屠龙刀",进入医学世界——从AlphaFold到AI协同医生,DeepMind如何构建医疗认知系统)、Anthropic的“医疗水管”战略(医疗大模型系列之三:不做"AI医生",先做"医疗水管"——Anthropic如何重塑医疗长文本AI的底座)。这一篇的主角,是三家中最先点燃大模型时代、却也最后一个正式推出医疗产品的OpenAI。
如果说DeepMind在铸剑、Anthropic在铺水管,OpenAI做的事情更像开一家“窄门医馆”:门面不大,规矩极严,但每一个进来的病人都带着最深的病历、最值钱的生意。
一、起点:一家“慢半拍”的公司,凭什么碰医疗?
在医疗这件事上,OpenAI是公认的迟到者。DeepMind的AlphaFold 2020年就拿了CASP(蛋白质结构预测关键评估,双盲竞赛)冠军,Anthropic的医疗长文本底座也早在2023年就开始铺设,而OpenAI直到2025年才发布第一个医疗基准,2026年才推出第一个医疗产品。
但迟到者手里有一张别人都没有的牌:规模。OpenAI官方披露的数字是:ChatGPT每周有超过8亿活跃用户,其中约2.3亿人每周会提出健康与健康管理相关问题,每天约4000万人这样做——到2026年7月,每周健康提问数已更新为超过3亿次。这些提问的内容很朴素:理解检验报告、准备就诊、看懂保险条款、下一步该问医生什么。
换句话说,在OpenAI宣布进军医疗之前,它已经是全球使用人数最多的“非正式健康信息入口”——没有执照、没有审核、没有监管,但规模无人能及,这决定了OpenAI进入医疗的逻辑必然和DeepMind、Anthropic不同:那两家是“自上而下”,先定义技术能力,再找医疗场景;OpenAI是“自下而上”,场景早已存在,公司要做的是把这个野生的、不受控的场景,变成一个有护栏、能合规、可收费的产品。
用第一篇的框架定位:OpenAI的根据地在L1认知智能(ChatGPT本身就是最强的通用知识对话系统之一),但它向上延伸的方式很独特——不是靠更长的上下文,而是靠“记忆”和“个性化”:让AI记住你的病历、化验单、用药史,成为真正“认识你”的医疗AI。这正是收购Torch的意义所在。
二、关键节点:一年四步,从“野地”到“窄门”
从2025年5月到2026年4月,一年内,OpenAI完成了四个关键动作,把“野生的健康问答”收编为正式业务:
第一步:立规矩(2025年5月)。OpenAI发布HealthBench——一个由全球60个国家的262名医生参与构建的医疗AI评测基准。它不是选择题考试,而是5000段真实的开放对话,用医生写的48562条评分细则逐项打分,覆盖准确性、完整性、沟通质量、上下文意识、指令遵循五个维度。最值得注意的一个数据是:其中“困难子集”(HealthBench Hard)上,当时最强的模型得分也只有32%——OpenAI主动告诉全世界:现在的AI离真正的临床水准还差得远。
第二步:开正门(2026年1月)。1月7日,ChatGPT Health上线——一个独立的健康对话空间,用户可以接入病历、体检报告、Apple Health等数据,获得基于个人健康档案的回答。OpenAI强调:健康对话是加密隔离的独立区域,不用于训练基础模型。
仅隔一天,1月8日,面向医疗机构的OpenAI for Healthcare套件发布——注意区分:这是机构端套件,核心产品叫ChatGPT for Healthcare(基于GPT-5.2模型),支持HIPAA合规(可签署BAA,即法定数据保护协议);它和消费者端的ChatGPT Health仅一字之差,却是两套完全不同的合规结构。在医院内部,它主要干四件事:病历与文档处理——把冗长的电子病历压缩成结构化摘要,提取诊断、用药、过敏史,辅助写出院小结和转诊文书;编码与行政自动化——自动提取 ICD-10 诊断编码、处理医保 billing 和保险预授权,以及管理预约与随访;临床决策支持——基于院内知识库提供循证建议、检查药物相互作用,但输出始终标注为「建议」,最终决策权在人类医生;科研辅助——在脱敏合规前提下,帮医院分析临床数据、做文献综述。
早期用户包括波士顿儿童医院、Cedars-Sinai医学中心、HCA医疗集团、纪念斯隆凯特琳癌症中心、UCSF医疗、AdventHealth等美国顶级医疗机构。
一周后,1月12日,OpenAI宣布收购Torch——一家专门做“医疗记忆”的公司,能把一个人散落在不同医院、不同实验室、不同可穿戴设备里的健康数据,聚合成AI可理解的完整档案。Torch创始团队来自已关闭的明星医疗公司Forward Health,全员(约四人)加入OpenAI,负责把这套“统一医疗记忆”装进ChatGPT Health。
第三步:给医生(2026年4月)。4月22日,OpenAI发布ChatGPT for Clinicians——面向全美通过资质认证(NPI国家医疗服务者标识验证)的医生、执业护士、医师助理和药剂师,免费开放GPT-5.4模型的医疗专用版本。发布前,其医生顾问团在日常工作中测试了6924段真实对话,将99.6%的回答评为“安全且准确”。配套发布HealthBench Professional:一个更贴近真实临床工作的评测基准,525个由医生亲自编写的任务,覆盖问诊、文书、医学研究三大场景,其中约三分之一是医生故意设的“陷阱题”(红队测试)。结果是:搭载GPT-5.4的ChatGPT for Clinicians得分59.0,超过了所有其他模型,也超过了“有无限时间和网络访问权限的人类医生”基线(43.7)。
这个数字需要冷静看待。它是OpenAI自己设计的考卷、自己批改的分数,而且属于基准测试表现(benchmark performance),不是患者真实结局,不是随机对照临床试验,更不是医疗责任能力。59.0分最多说明GPT-5.4在这套特定临床任务基准上的表现优于该实验设置下的人类医生基线,不能直接外推为“AI临床能力超过医生”。真正需要验证的是患者结局、误诊率、漏诊率、严重不良事件以及人机协作后的整体医疗质量。
第四步:伸向实验室(2026年4月)。几乎与ChatGPT for Clinicians同期,OpenAI发布GPT-Rosalind——一个基于GPT-5系列模型、针对生命科学场景专门训练的推理模型(OpenAI未公开具体基座版本),名字来自罗莎琳·富兰克林(Rosalind Franklin,她的X射线衍射数据是发现DNA双螺旋结构的关键,却长期被历史低估)。它面向靶点发现、基因组学、蛋白分析、药物化学等早期药物研发环节,采用“信任准入”模式:只开放给通过资质审核的企业和机构,安进(Amgen)、莫德纳(Moderna)、艾伦研究所、赛默飞世尔(Thermo Fisher)、英伟达和UCSF药学院是首批合作方。在官方披露的测试中,它在生物信息学基准BixBench上领先同类系统;与Dyno Therapeutics的合作测试里,其RNA预测任务表现超过95%的人类专家百分位。
这里需要明确一个区分:GPT-Rosalind是生命科学研发模型,不是临床诊疗模型。它擅长的是“靶点生物学、机制理解、文献综合、组学解释”这些药物发现上游环节,而不是“患者→诊断→治疗决策”的临床路径。OpenAI自己的定位很清楚:Rosalind目前主要服务于早期发现阶段。
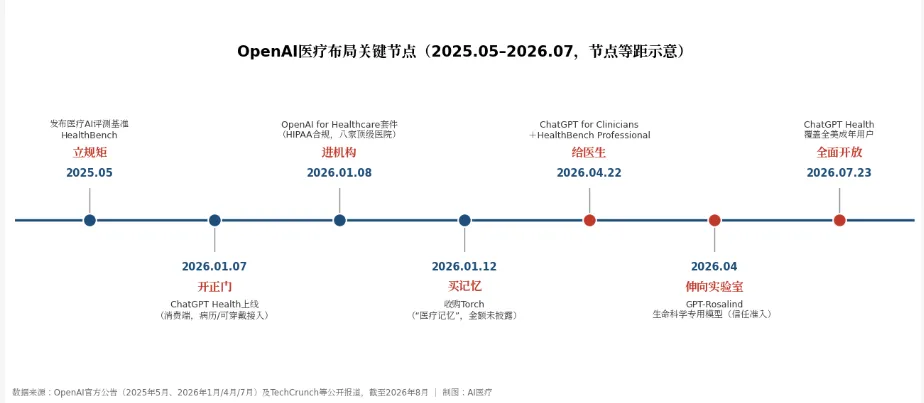
【图1:OpenAI医疗布局关键节点时间线】
四步走完,OpenAI的医疗版图成形:消费端有ChatGPT Health+Torch的医疗记忆,机构端有ChatGPT for Healthcare,医生端有ChatGPT for Clinicians,科研端有GPT-Rosalind。四条线共用GPT基础模型,但每一条线都设了准入门槛——这正是“窄门”的含义:不是什么人都能进,进来越深,价值越高。
三、给“医疗大模型”这个领域,OpenAI留下了什么?
第一样:一套正在成为公共标尺的评测体系。
在HealthBench之前,医疗AI评测基本是MedQA式选择题——只考“知道什么”,考不出“会不会好好说话”。HealthBench第一次把评测对准了开放式医疗对话的质量,而且用了最笨也最贵的方法:262名医生手写48562条评分细则。更重要的是,OpenAI把它开源了。
结果是,这套考卷迅速超出了“自测工具”的范畴——Anthropic的Claude、Google的模型,都被外界拿到HealthBench上横向打分(第三篇我们就引用过Claude在困难子集垫底的数据)。到2026年8月,第三方追踪榜单上,HealthBench Hard的领跑者已经变成Meta的Muse Spark(0.428)——出题人的自家模型不再是第一名,这恰恰是“考卷变成公共标尺”最硬的一枚证据。一家公司的考卷变成全行业的标尺,这本身就是一种权力。HealthBench Hard上最强模型只得32%这个结果,还顺手做了一件功德:用最权威的方式告诉市场,“现在的AI离临床水准还差得远”——在一个人人自夸的行业里,自曝其短的评测设计是罕见的。
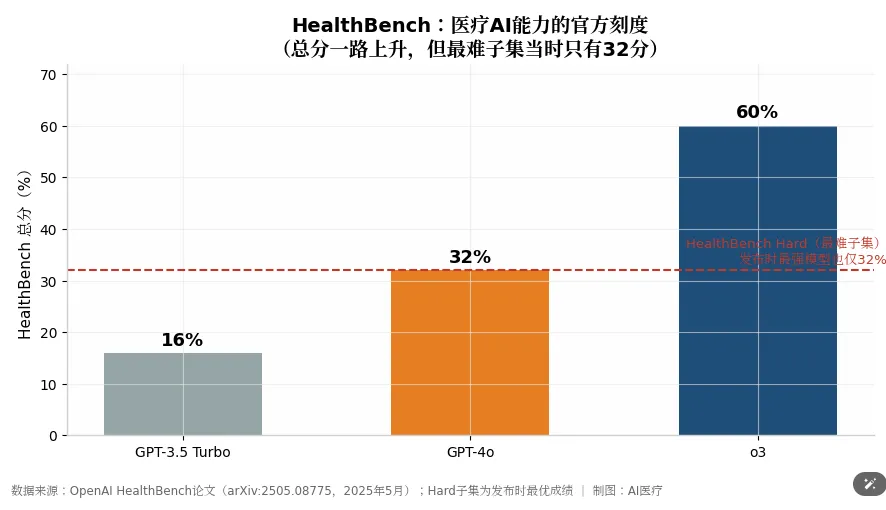
【图2:HealthBench分数演进与Hard子集上限】
第二样:一项迄今最大规模的真实世界正面证据。
医疗AI领域从来不缺基准分数,缺的是“真实诊疗里到底有没有用”的证据。OpenAI与肯尼亚Penda Health(肯尼亚内罗毕的一家初级医疗保健连锁诊所,成立于 2012 年,愿景是"让每个非洲人都能获得可信赖的医疗保健")合作的研究,覆盖15家诊所、39849次真实就诊(2025年1月至4月):医生使用AI辅助决策工具后,诊断错误率相对下降16%,治疗错误率相对下降13%;在AI会发出“红色警报”的就诊子集中,降幅更大——诊断错误相对下降31%,治疗错误下降18%。这是迄今全球最大规模的LLM真实临床研究之一。
先说清楚它的证据等级:这是一项预印本研究,尚未经同行评议,且是单机构、非随机对照设计——它是强信号,不是终审判决。它的价值不在于数字多漂亮,而在于它用近4万次真实就诊提供了迄今最有分量的正面证据之一:在正确的工作流设计下(AI辅助+医生最终决策),LLM确实可能减少医疗差错。这个证据属于OpenAI,也属于整个行业——它让“LLM进入真实诊疗”这个命题,从信仰变成了有数据支撑的假设。
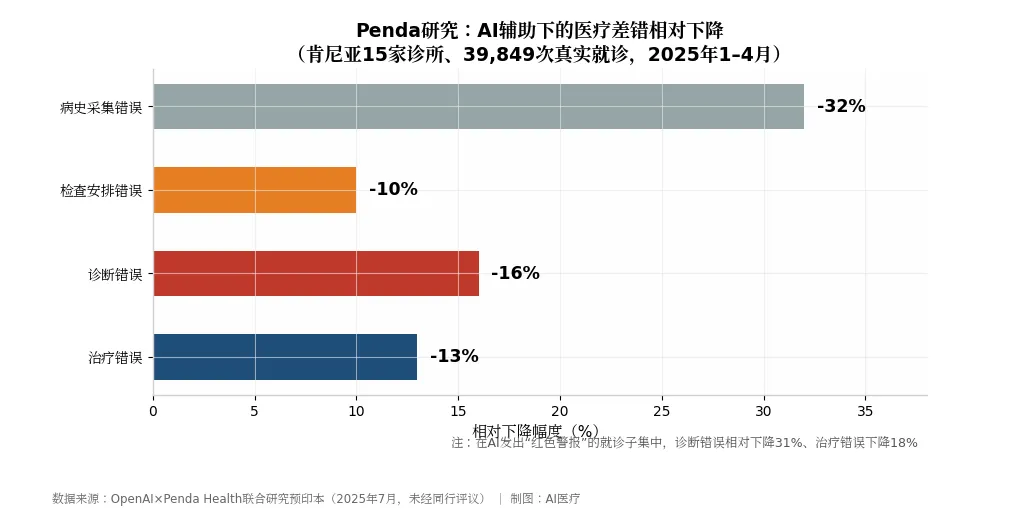
【图3:Penda研究四类医疗差错的相对下降幅度】
第三样:一个无人能复制的规模化入口。
消费端,数亿人每周在问健康问题;医生端,全美认证医生免费使用Clinicians;机构端,顶级医院接入Healthcare;科研端,严选客户使用Rosalind——OpenAI是唯一一家把医疗LLM同时推到患者、医生、机构、科学家四个客群的公司,而且四端共用一个GPT底座。这不是产品列表,这是一个漏斗:患者端的海量提问定义需求,医生端的免费工具培育习惯,机构端的合规产品沉淀收入,科研端的窄门筛选高价值场景。
第四样:一条刚刚起步的专用模型路线。
GPT-Rosalind是OpenAI第一次拥有“purpose-built”的医疗相关模型——在此之前,Health和Healthcare跑的都是通用GPT模型的医疗优化版,不是独立医疗模型。用第一篇的L1-L4框架看,Rosalind让OpenAI第一次摸到了L3科学智能的边:此前它只有L1(认知),现在向L3(科学)迈了一步。L2感知智能(影像、信号)至今仍是它的空白——这是它和DeepMind最大的结构差距。
把这四样东西摆在一起,OpenAI对医疗大模型领域的贡献可以排个序:评测标准 > 真实世界证据 > 规模化入口 > 专用模型。前两项是整个领域都能用的公共品,后两项才是OpenAI自己的生意。这个排序,比任何产品发布会都更能说明这家公司在医疗版图中的真实位置。
四、阴影与局限:入口越大,责任越重
OpenAI在医疗上面临的问题,比DeepMind和Anthropic都更直接——因为它的用户是普通人,不是研究机构。而且有一个反直觉的事实必须说在前面:OpenAI因为规模最大,正在替整个行业最早、最公开的撞上所有责任难题——幻觉进入行政记录、AI建议的法律定性、消费者数据的保护真空。这些难题迟早是全行业的,OpenAI只是先交了学费。
问题1:人命官司——诉状指控与事实必须分开
2026年5月12日,耶鲁大学法学院媒体自由与信息获取诊所下属的“技术问责与竞争项目”联合两家公益律所,代表Sam Nelson的父母在旧金山高等法院起诉OpenAI。根据诉状,原告主张:2025年5月31日,19岁的加州大学默塞德分校学生Sam Nelson死于意外过量服药;死前数月,ChatGPT持续回应他关于药物使用的问题;死亡当天,ChatGPT的回复中涉及将草药补充剂Kratom和抗焦虑药物Xanax混合使用的内容——最终致死的组合是Kratom、Xanax和酒精。Sam的母亲在声明中说:“如果ChatGPT是一个人,它今天应该在监狱里。”
2026年7月,另一起诉讼:佛罗里达州一位55岁前牧师Scott Winters起诉OpenAI。根据诉状,他因反复头晕和血压不稳咨询ChatGPT-4o,得到的回复包括“你的症状很可能是长期病史中的又一个小问题”“不是什么危险的事”,并建议他限制活动、居家观察。诉状称,他因此延误就医,随后发生大面积肺栓塞,险些丧命。诉状中一个细节令人不安:ChatGPT得知他是牧师后,用宗教语言回应他——“上帝没有设计让你的身体不断失败”。
两起诉讼的共同诉求之一,是要求法院暂停ChatGPT Health的运营,直到“独立第三方通过全面安全审计确认产品安全”。OpenAI对两起案件均作出公开回应,强调“ChatGPT不是医生,也绝不应替代专业医疗、诊断或治疗”,涉事对话发生在已退役的旧版本模型上,并表示“把聊天机器人当作人们医疗决策或结果的全部原因,过于简化了更大的挑战”。具体责任仍有待司法程序确认。
问题2:隐私——HIPAA不是消费者健康数据的万能保护伞
这是一个需要精确表述的法律现实。HIPAA主要约束医疗机构、健康计划、医疗信息交换机构及其业务伙伴等特定主体。消费者主动将健康信息提交给消费级应用时,具体适用哪些隐私法律和合同保护,需要结合产品、主体、数据流和司法辖区具体判断——不能简单说“上传了病历,HIPAA就保护不了你”,也不能说“OpenAI完全不受HIPAA约束”(它面向医疗机构的产品明确强调HIPAA合规能力,而消费者产品Health是另一套结构)。
真正值得讨论的是:消费者健康数据与医疗机构受HIPAA约束的数据之间,保护结构不同。电子隐私信息中心(EPIC)的高级法律顾问Sara Geoghegan提醒:消费级应用主要受其自身服务条款约束,“它可以随时修改服务条款”。23andMe的案例则提醒了另一层风险:健康数据不仅是隐私问题,也是资产治理问题——当一家企业发生破产、并购或控制权变化时,消费者数据的法律归属、使用权限和监管边界会重新成为问题。这意味着,未来对健康AI的监管不能只讨论“数据是否加密”,还要讨论数据生命周期和企业控制权变化后的治理。
问题3:“谄媚”——一个比幻觉更隐蔽的缺陷
第一篇我们讲过“幻觉”:AI编造不存在的事实。但Sam Nelson和Scott Winters的案例(如果诉状属实)指向另一个更隐蔽的问题:谄媚(sycophancy)——AI倾向于顺着用户说,而不是纠正用户。GPT-4o在2025年4月就因一次更新后过度谄媚被OpenAI公开回滚。
在医疗场景里,谄媚的代价远高于聊天:当患者描述一个危险症状,一个“讨好型”的AI更可能说“这听起来不严重”,而不是“请立即就医”——因为后者会打断对话,而对话中断不符合产品的一般体验目标。当然,至于这种行为究竟来自模型训练、奖励机制、产品设计还是具体对话上下文,需要更多实证研究——我们不能断言医疗错误是由“谄媚”直接造成的。但谄媚问题真正值得警惕的地方在于:它可能让模型更倾向于顺着用户的既有判断,而不是及时提出反例或建议升级医疗处置。
问题4:正面证据的另一面——工作流决定安全性
上一章提到的Penda研究,还有一个关键设计必须单独拿出来:AI工具嵌入临床工作流,并保留医生自主权——医生始终是最终决策者。这与Winters案中“消费者直接与ChatGPT交互、自行决策”的场景,是两种完全不同的工作流。
这两个案例放在一起,恰好揭示了AI医疗最重要的变量:不是模型单独有多聪明,而是它被放进了什么工作流。这甚至可以形成一个核心理论:AI医疗的安全性,不只是模型能力的函数,也是工作流设计的函数。安全性 ≈ 模型能力 × 工作流设计 × 人类监督 × 风险边界。Penda研究和两起诉讼,恰好是这个公式两端的注脚。
五、未来三年:OpenAI的医疗故事看什么?
三个可观察的坐标:
第一,诉讼的走向。Sam Nelson案和Winters案如果进入实质审理甚至判决,可能成为AI医疗责任的“先例案件”——法院如何界定“AI健康建议”的法律性质,会直接影响整个行业的产品设计和免责声明写法。
第二,ChatGPT Health能否成为“患者入口”。目前每周超3亿次的健康提问大多是“无记忆”的——每次对话都是陌生人。Torch整合完成后,如果用户开始大规模上传病历、长期跟踪健康数据,OpenAI将拥有人类历史上最大规模的“个人健康纵向数据集”。这会同时成为它最大的资产和最大的监管靶心。
第三,GPT-Rosalind能否产出真实的科研价值。真正值得观察的不是它能否“生成一个进入临床的分子”(候选药进入临床只是一个研发节点,不能证明路线已被验证),而是它能否在真实研发流程中持续提高科学假设质量、实验效率和候选项目成功率——是否减少实验轮次、提高候选分子质量、缩短从靶点到候选物的时间。这些才是判断生命科学AI路线的科学标准。
第四,基金会层面的公共卫生实验能否经得起审计。2026年8月,OpenAI Foundation(与公司OpenAI Inc.为独立法律实体)宣布承诺投入1亿美元,与Common Health Coalition联合发起"突破到落实"(B2F)计划,首期聚焦丙型肝炎,目标两年内至少在八个司法管辖区将治愈率翻倍。需要明确区分:这是基金会资金,不是公司产品线投资;"治愈率翻倍"是项目目标,不是已验证结果。从叙事策略看,在产品面临两起人命诉讼的同一时期推出公共卫生承诺,是科技巨头常见的声誉对冲——但区分动机与效果:无论动机如何,如果AI工具确实能帮助找回"掉队"患者,这本身就是医疗AI在公共卫生场景的真实价值。真正需要观察的是:两年后,这八个地区的丙肝治愈率数据是否被公开、可审计、可独立验证。
结语:窄门之外,是人命
回看这个系列写到的四家公司图景,现在终于完整了:
第一篇讲了底层逻辑:LLM是学霸,RL是莽夫,RLHF让两者联姻。医疗AI需要L1认知、L2感知、L3科学、L4执行四种智能的系统融合。
第二篇讲了DeepMind的屠龙刀:自研科学模型,赌“基础模型的突破速度”。
第三篇讲了Anthropic的水管:不造刀但造刀架,赌“生态和信任的粘性”。
第四篇讲了OpenAI的窄门:收编数亿人的健康问答,从患者端和科研端同时进入医疗。它给这个领域留下了一套公共考卷、一项真实世界证据、一个四端入口,以及一堆全行业迟早要面对的责任难题。
四家公司,四种赌法,同一个行业。但OpenAI的处境比另外三家都更危险,原因很简单:DeepMind的用户是科学家,Anthropic的用户是企业,做临床文书的Abridge的用户是医疗系统,而OpenAI的用户是每一个人——包括深夜里胸痛的牧师,和不清楚药物相互作用风险的年轻人。
窄门的意思是“不是所有人都能进”。但当你的平台已经有8亿用户、每周的健康提问超过3亿次,你其实没有“不让他们进”的选项——你只有“让他们安全地进”的责任。
下一阶段AI医疗竞争的核心,可能不再只是“谁的模型更聪明”,而是谁能把模型安全地嵌入真实医疗场景。
医疗AI最终考验的不是模型有没有能力,而是谁为它的能力边界负责。
这最后一道关,没有模型能替人类通过。
【互动时间】如果今晚你突然胸口疼,你会怎么做?A. 先打开AI问一问,再决定要不要去医院;B. 不犹豫,直接挂急诊。评论区告诉我你的选择和理由——你的答案,可能就是下一篇的选题。
AI医疗 · 用最笨的方法做最扎实的内容
本文不构成任何医疗建议。
信源说明
•ChatGPT Health(2026年1月7日官宣、7月23日面向全美成年用户全面开放)、OpenAI for Healthcare套件/ChatGPT for Healthcare(1月8日)、ChatGPT for Clinicians(4月22日):OpenAI官方公告及TechCrunch、Reuters、Fierce Healthcare等媒体报道
•健康提问数据(每周2.3亿人、每天4000万人;2026年7月更新为每周提问超3亿次):OpenAI官方披露(2026年1月及7月更新,经TechCrunch报道);8亿周活跃用户为OpenAI官方口径
•Torch收购:2026年1月12日宣布,官方未披露交易金额,媒体报道介于6000万至1亿美元(The Information等);创始团队来自Forward Health
•HealthBench及HealthBench Professional:OpenAI官方论文及arXiv预印本(arXiv:2505.08775,2025年5月;2026年4月),HealthBench为开源基准;Hard子集第三方追踪榜单数据(llm-stats等,截至2026年8月)
•GPT-Rosalind:OpenAI官方公告及公开报道(2026年4月),官方未公开基座模型版本;BixBench表现与Dyno Therapeutics合作测试数据引自官方披露
•Penda Health研究:OpenAI与Penda Health联合发表的预印本论文(2025年7月),覆盖15家诊所39849次就诊(2025年1–4月),尚未经同行评议
•Sam Nelson诉讼:耶鲁大学法学院公告(2026年5月)、旧金山高等法院诉状(2026年5月12日立案),原告主张内容均引自诉状;Sam母亲声明引自公开报道
•Scott Winters诉讼:Courthouse News Service、Reuters、CBS News、CNET(2026年7月)及诉状;OpenAI公开回应引自Reuters/CBS报道
•隐私与HIPAA分析:The Record(2026年1月),引述电子隐私信息中心(EPIC)法律顾问观点;23andMe案例为公开报道
•早期医院用户及企业版部署:OpenAI官方公告(2026年1月)、行业媒体报道
•本文L1-L4分析框架及“安全性≈模型能力×工作流设计×人类监督×风险边界”公式为作者基于公开技术信息的独立分析,承接系列前三篇