4年缩短到4周!让"医学孤儿(罕见病)"被AI看见
全球3亿罕见病患者,平均确诊要等4.7年,六成被误诊过;而AI正在把这场"确诊马拉松"压缩到数周甚至数小时——上海交大与新华医院的DeepRare今年2月登上《自然》,全国罕见病诊疗协作网平均确诊时间已从约4年缩至4周。
本文系统梳理全球与中国的AI罕见病版图:三条诊断技术路线、一张全球机构图谱、中国"医院+科研"矩阵、专科大模型基座、AI制药的经济学,以及必须直面的冷思考。
摘要
罕见病单病种患者稀少,但全球已知病种超过7,000种,受累人群约3亿至4亿人——"罕见"的集合并不罕见。长期以来,罕见病研究受制于三重结构性困境:确诊难(欧洲患者平均确诊时间4.7年,约六成曾被误诊)、研究难(病例分散、数据稀缺)、治疗难(约95%的罕见病没有获批疗法)。
人工智能正在三个层面改写这一格局:在诊断端,面部识别、基因组智能解读与大语言模型(LLM)把"平均数年"的诊断漫游压缩到数周甚至数小时;在研究端,国际联盟与国家级登记系统借助AI盘活存量数据,让未确诊病例获得"第二次诊断机会";在药物端,知识图谱与生成式AI让"老药新用"和靶点发现的成本数量级下降。
2025年以来,中国密集涌现出"协和·太初"、"哪吒·灵童"、"明岐"等罕见病专科大模型,上海交大与新华医院联合研发的DeepRare更于2026年2月登上《自然》(Nature),成为全球首个可溯源智能体式罕见病诊断系统。本报告系统梳理全球与中国罕见病研究机构、医院与科研组织的AI应用版图,并对AI罕见病专科模型的技术路线、代表产品与治理挑战进行全景式分析。
一、罕见病之困:为什么AI成为"破题之钥"
1、罕见病的定义及“诊断漫游”
罕见病(rare disease)通常指患病率极低的一类疾病——欧盟标准为每万人中少于5人,美国定义为受累人数少于20万。单一病种虽"罕",病种总量却极其庞大:全球已知罕见病超过7,000种,合计影响约3亿人,约占世界人口的3.5%–6%;其中约72%具有遗传起源,70%在儿童期发病,疾病负担的约四分之三落在儿童身上。中国有超过2,000万罕见病患者,每年新增约20万例,约30%的罕见病患儿在5岁前离世。
然而,与沉重的疾病负担形成鲜明对照的是诊疗供给的严重不足:全球仅约5%的罕见病拥有获批治疗手段,能够诊治罕见病的医生比患者更"稀缺"。
患者首先要熬过的是漫长的"诊断漫游"(diagnostic odyssey)。欧洲罕见病组织EURORDIS覆盖42国、10,000余名患者、1,675种罕见病的Rare Barometer调查显示,患者从症状出现到确诊平均耗时4.7年,25%的患者确诊前就诊于8名以上医生,60%曾被误诊为其他躯体疾病,60%曾被误判为心理问题或症状被忽视;女性平均确诊时间5.4年、显著长于男性的3.7年,10–20岁青少年患者甚至平均要等10.4年。
中国《2020中国罕见病综合社会调研》对20,804名患者的调查同样发现,42%的患者曾被误诊,误诊一年以上者平均确诊时间达4.26年。北京协和医院团队给出的数据更为严峻:超过70%的罕见病病例存在误诊、漏诊问题。即便在已建立罕见病注册转诊体系的意大利,平均诊断延迟仍有3.4年,西班牙报告的平均延迟更达6.8年。
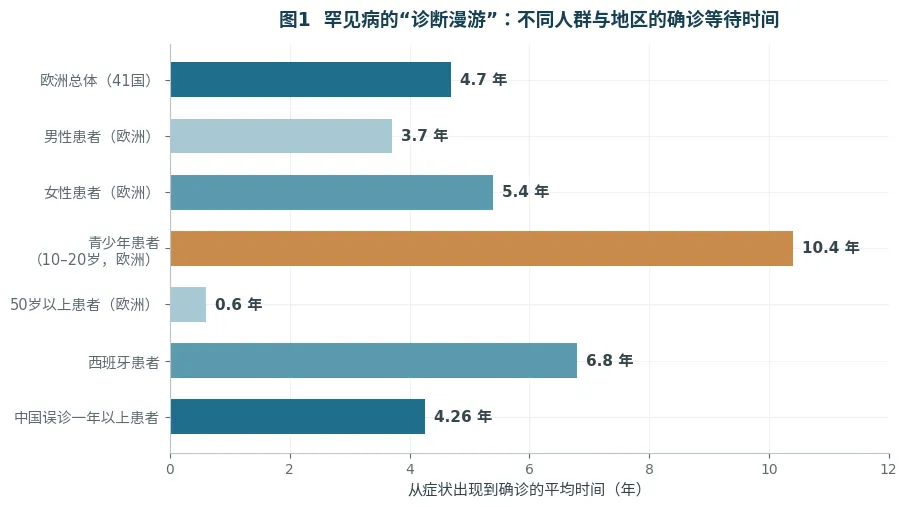
图1 罕见病的"诊断漫游"(来源:原报告整理)
2、罕见病研究的另一重困境是数据的"小、散、缺"。
单病种病例少且分散在全球各地,传统AI依赖的大规模标注数据无从谈起;表型描述缺乏统一语言,基因变异致病性判读高度依赖少数专家经验。
AI之所以被寄予厚望,恰恰因为新一代技术范式能够针对性化解这些瓶颈:小样本学习与"知识+数据"混合驱动缓解了数据稀缺,知识图谱与大模型盘活了沉睡在文献和病历中的知识,多模态模型则把面部影像、医学影像、基因组数据整合进同一条推理链。
从2003年到2023年,全球罕见病与AI交叉领域共发表约1,501篇研究论文,经历了启动期、稳定发展期和加速增长期三个阶段,研究焦点集中于基因识别、疾病管理与个性化治疗。可以说,罕见病已成为检验AI医疗成色的"压力测试场",而AI也成为罕见病研究走出"偶然确诊"时代的关键变量。
二、诊断革命:AI破解罕见病确诊难题的三条技术路线
1、面部与影像表型识别:从"看面相"到下一代表型组学
约半数罕见遗传病伴有特征性面容,但能够识别这些细微表型的临床遗传专家全球屈指可数,这让"AI看面相"成为罕见病AI应用中最早成熟的路线。美国FDNA公司(总部位于美国波士顿的私营数字健康公司,成立于2011年)开发的DeepGestalt深度学习框架,依托Face2Gene(一款基于深度学习的面部识别应用,专门用于辅助诊断罕见遗传病。)手机应用积累的17,000余张、覆盖200余种综合征的患者面部图像训练而成,2019年发表于《自然·医学》(Nature Medicine)的研究显示,其在502张图像、92种综合征的测试中top-10准确率超过90%;在德朗热综合征、天使综合征等单病种识别任务上准确率超过90%,明显优于临床专家约70%的水平。这一"下一代表型组学"(next-generation phenotyping)工具目前已覆盖215种以上遗传综合征,被全球临床遗传科广泛使用。
更进一步,德国波恩大学团队与FDNA合作开发的GestaltMatcher解决了"训练集之外的疾病怎么办"的难题:它不再做封闭式分类,而是把患者面部特征映射到多维空间中进行"患者—患者"匹配,支持超罕见病甚至未知疾病的诊断与聚类。该系统基于17,560张、涵盖1,115种罕见病的肖像照片训练,约三分之一的超罕见或未确诊病例可通过面部相似性获得匹配线索,成果发表于《自然·遗传学》(Nature Genetics)。在德国国家罕见病计划TRANSLATE NAMSE中,16所大学医学中心对外显子测序数据结合GestaltMatcher面部分析,一次性确认了34种此前未知的新遗传疾病,这也是AI面部软件首次大规模支持临床诊断。
影像侧同样活跃:上海交通大学LoCCS实验室王烁团队研发的"明岐"医学影像多模态大模型矩阵(2025年3月发布),在中南大学湘雅三医院针对克罗恩病等消化道疑难病的临床验证中诊断准确率超过92%,被认为超越专科高级医师水平,且通过模型蒸馏与量化技术将部署成本从百万元级GPU服务器降至约10万元的一体机,为基层落地扫清了算力门槛。
2、基因组智能解读:从数周人工判读到“十余小时确诊”
约80%的罕见病与遗传相关,基因组测序产生的数百万个变异需要逐一判读,这正是AI大显身手的环节。经典工具Exomiser以人类表型本体(HPO)为桥梁进行表型驱动的变异排序,长期作为国际通用标准。英国10万人基因组计划(100,000 Genomes Project)的先导研究显示,自动化虚拟基因panel加Exomiser表型排序的组合,可在国家医疗体系内为25%的既往未确诊罕见病先证者(即一个家族中首位被确诊的患者)给出分子诊断,其中14%的诊断来自其他检测手段无法覆盖的非编码区、结构变异等区域,该项目最终让四分之一的罕见病参与者首次获得诊断,并直接催生了英国NHS基因组医学服务体系。
AI的深度介入进一步压缩了时间与人力成本。美国Rady儿童基因组医学研究院与Fabric Genomics合作的Fabric GEM算法,在六家基因组中心的回溯性研究中对危重新生儿致病变异的首位/次位排序命中率超过90%,大幅减轻了临床遗传医师的变异审阅负担;Rady研究院更将超快速全基因组测序的确诊纪录刷新至13.5小时。并在2022年推广至81家儿童医院,其BeginNGS项目正试点以基因组测序结合AI为新生儿筛查500余种罕见病。
在变异致病性预测这一基础科学问题上,哈佛医学院与巴塞罗那基因组调控中心2025年11月发表于《自然·遗传学》的popEVE深度生成模型融合了跨物种进化信息与人类群体数据,实现全蛋白质组尺度的变异有害性校准评分:在31,000余个严重发育障碍家庭中,98%已明确致病位点的病例被popEVE正确地排在该儿童基因组变异首位,性能超越DeepMind的AlphaMissense,且仅凭患儿单方外显子即可完成致病位点排序——这对无法获得父母样本的家庭意义重大;该模型还在发育障碍队列中识别出442个基因中的致病变异,包括123个全新候选疾病基因。一项纳入22项研究、超过25,000个变异的荟萃分析显示,AI变异解读工具的合并敏感度达92.3%、特异度89.5%,显著优于传统规则算法,临床WES/WGS研究中AI的整合平均提升诊断率12.8%、减少意义未明变异(VUS)25%–40%。
3、大模型与智能体:罕见病诊断的"第三代范式"
大语言模型的出现让罕见病诊断从"模式匹配"跃迁到"知识推理"。美国国立卫生研究院(NIH)资助的未诊断疾病网络(UDN)2025年发表于JAMA Network Open(《美国医学会杂志》旗下的开放获取综合性医学期刊)的研究首次系统评估了LLM在真实疑难病例中的表现:在90个经UDN确诊的病例上,GPT-4o的鉴别诊断列表命中最终诊断的比例为13.3%,显著高于历史临床回顾的5.6%,若计入"接近正确"的有益提示则达23.3%,且单病例成本仅约0.03美元、耗时5秒。这一结果提示,通用大模型已能在"人类专家都觉得棘手"的病例中提供有价值的初始鉴别方向,但距离独立确诊仍有差距。
面向罕见病专门优化的智能体(Agentic AI)系统则把性能推向了新高度。
上海交通大学人工智能学院与附属新华医院联合研发的DeepRare采用"中枢—分身"多智能体架构,通过"假设—验证—自我反思"的类医生"慢思考"循环开展循证推理,在仅输入临床表型时首位诊断准确率达57.18%,较此前国际最佳模型(Claude-3.7-Sonnet推理版,33.39%)提升23.79个百分点;引入基因测序数据后综合首位准确率达70.6%,显著优于Exomiser的53.2%,其生成的带完整证据链的推理报告获得临床专家95.4%的认可。该成果2026年2月18日在线发表于《自然》杂志。杂志同期配发的评论指出,DeepRare打破了AI临床诊断的"黑盒",其"实时知识检索+自我反思迭代"框架为需要复杂逻辑推理的领域提供了通用解题思路。
评测基础设施也在同步完善:RareBench基准系统评估LLM在罕见病分析四大维度的能力,上海人工智能实验室等2026年发布的MMRareBench进一步覆盖多模态、多影像证据整合,其对23个多模态大模型的系统评测显示,当前模型在罕见病"治疗规划"维度普遍薄弱(最优模型也仅49.2分),医学微调模型在多影像整合任务上反而落后于通用模型,为领域指明了改进方向。
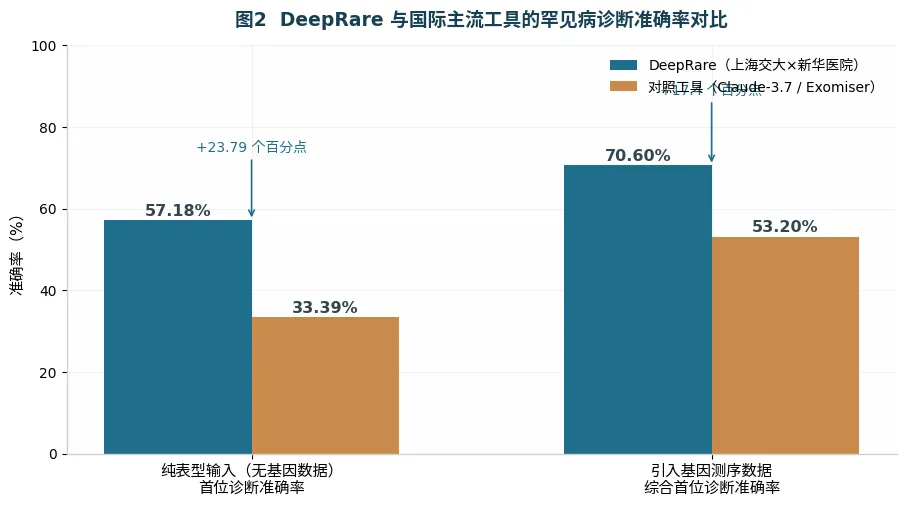
图2 DeepRare与国际主流工具的诊断准确率对比(来源:原报告整理,数据引自Nature论文)
三、全球机构图谱:谁在用AI攻克罕见病
1、国际研究联盟与国家级计划:把分散的数据连成网络
罕见病研究的天然碎片化决定了"联盟化"是全球主线。国际罕见病研究联盟(IRDiRC)2011年由欧盟委员会与美国NIH共同发起,聚合资助机构、学术界、企业、监管方与患者组织,其2017年更新的愿景是"所有罕见病患者在就诊后一年内获得准确诊断",并设定了到2027年新增1,000种罕见病疗法的目标。联盟推动的Matchmaker Exchange建立了跨数据库的基因型—表型联邦匹配网络,让"全球只有两三例"的患者能够彼此找到,是AI时代罕见病数据共享的基础设施级创新。
(1)欧洲层面,欧盟2017年整合罕见病专业力量成立24个欧洲参考网络(ERNs)。依托ERNs组建的Solve-RD泛欧联盟对来自37个专家中心、6,004个未确诊家庭的6,447名个体的存量基因组数据开展系统性再分析,通过"数据分析特别工作组+两级专家评审"的协作框架额外确诊12.6%的家庭,成果发表于《自然·医学》。其基础设施已被RDMM-Europe项目沿用并扩展至全部24个ERN。作为欧洲罕见病联合计划(EJP RD)的延续,欧洲罕见病研究联盟(ERDERA)于2024年启动并将运行至2034年,汇集36个国家的171家机构,围绕诊断研究、结局研究、创新疗法等支柱协调跨国研究。
(2)美国与英国则走"国家项目+医疗体系嵌入"路线。NIH的未诊断疾病网络(UDN)自2014年建立以来形成了"临床站点+测序核心+模型生物筛选中心"的多学科体系,对完成评估的疑难病例诊断率约35%,并新定义了31种综合征,已成为全球未确诊疾病诊疗的范式样板。英国10万人基因组计划完成了约8.5万名NHS患者(罕见病与癌症)的测序,18.5%的数据转化为可操作结果,并在此基础上建立了常态化的NHS基因组医学服务,正在推进50万例全基因组测序的医疗级应用。这些国家级项目的共同经验是:只有把表型采集(HPO术语)、测序、自动化变异解读与专家评审整合为一条标准化流水线,AI的效率红利才能在真实医疗体系中兑现。
2、先锋医院:从单体工具到全院级智能体系
医院是AI罕见病应用落地的"最后一公里",全球已涌现出一批标杆机构。
(1)美国Rady儿童医院(圣迭戈)以超快速全基因组测序结合Fabric GEM人工智能算法,把危重新生儿罕见遗传病的确诊时间压缩到13.5小时,其快速全基因组测序已在18个州获得Medicaid支付覆盖,新生儿基因组筛查项目BeginNGS则以"基因组+AI"模式试点500余种罕见病的出生筛查,代表了"诊断前移"的方向。
(2)范德比尔特大学医学中心作为UDN站点,率先将大模型纳入未诊断疾病的鉴别诊断流程评估,为LLM进入疑难病多学科会诊提供了循证依据。德国以波恩大学医院为核心,依托16所大学罕见病中心组成的TRANSLATE NAMSE网络,将外显子测序与GestaltMatcher面部AI联合用于大规模临床诊断,一次性发现34种新遗传病,展示了"AI+国家罕见病网络"的乘数效应。
值得注意的是,国际医院实践呈现出清晰的分工逻辑:Rady模式解决"快"(危重患儿的时效性),波恩模式解决"广"(网络化大规模筛查诊断),UDN模式解决"难"(穷尽手段后的兜底确诊),三者共同构成AI时代罕见病诊断的机构协作范式。与之呼应,患者组织与公益项目也在补齐可及性短板——iHope项目在21个国家提供免费全基因组测序,诊断率超过40%,70%的发现改变了临床管理方案。
3、数据与知识基础设施:AI的"隐形地基"
所有上层应用都建立在一批公共知识库之上。人类表型本体(HPO)由Robinson等于2008年提出,以分层本体统一描述疾病表型,目前已完成对OMIM中7,000余种遗传病和Orphanet中3,000余种罕见病的标准化标注,被NIH未诊断疾病计划、英国10万人基因组计划、DECIPHER、欧洲参考网络以及中国国家罕见病注册登记系统普遍采用。
2016年成立的中文人类表型标准用语联盟完成了HPO词汇的汉化,为国内AI辅助诊断工具奠定了语言基础。Orphanet收录近6,000种罕见病及孤儿药(指针对罕见病的药物,因患者少、商业回报低而得名)信息,是目前最全面的罕见病知识库;OMIM汇集已知遗传病、性状与基因的关系;DECIPHER则沉淀了200余家研究中心上传的逾万例真实临床案例。
近年来,大模型技术反过来也在改造这些基础设施。Köhler等通过持续完善HPO为罕见病精准表型描述提供支持;研究者通过微调开源Llama模型开发出罕见病表型概念标准化新方法,显著提升了表型术语识别与归一化性能。可以认为,HPO、Orphanet、OMIM等构成了罕见病AI的"知识底座",而GA4GH、Matchmaker Exchange、RD-Connect GPAP等平台则构成了数据流通的"管道层",二者共同决定了专科模型能够达到的智能上限。
四、中国实践:政策底座、医院集群与科研机构协同
1、政策与体系底座:罕见病治理的"中国框架"正在数智化
(1)中国罕见病防治体系近年快速成型,为AI应用提供了制度与数据土壤。国家先后于2018年、2023年发布两批罕见病目录,共收录207种罕见病;2019年国家卫健委遴选324家医院组建全国罕见病诊疗协作网(北京协和医院为唯一国家级牵头医院),至2025年已扩展至419家。
国家罕见病直报系统已覆盖全国31个省级行政区、236个地级行政区,登记病例总数达164万例,构成全球罕见的真实世界数据资源。
支付端,约100种罕见病药物纳入国家医保目录、覆盖42个病种,2024年医保基金为协议期内罕见病药品支付86亿元;2025年12月最新一轮调整中,国家医保目录再新增10种罕见病用药,首版商保创新药目录同步纳入6款罕见病用药(涵盖戈谢病、神经母细胞瘤等),均自2026年1月1日起执行——罕见病保障正式从"医保单轨"迈入"医保+商保双轨"时代。
2024年8月,贵州省与北京协和医院共建的国家级罕见病大数据中心正式启用,初步建成全国规模最大的罕见病大数据平台。
(2)AI已被明确写入国家罕见病治理议程。
2025年11月,国家卫健委等五部门联合发布《关于促进和规范"人工智能+医疗卫生"应用发展的实施意见》,提出到2027年形成一批临床专病专科垂直大模型和智能体应用、到2030年基层诊疗智能辅助基本实现全覆盖,并明确要求国家医学中心和区域医疗中心"聚焦儿科、精神、肿瘤及罕见病等重大疑难疾病临床决策智能辅助应用",同时鼓励面向罕见病开发新药筛选模型、加速新药智能研发。
2026年2月发布的《2026罕见病行业趋势观察报告》显示,随着协作网优化与AI辅助工具落地,协作网内平均确诊时间已从约4年缩短至4周,《2025年国家医疗质量安全改进目标》也首次将罕见病纳入年度医疗质量重点领域。
2、医院与科研机构:从通用大模型到单病种智能体的中国矩阵
(1)中国的罕见病AI实践以"顶尖医院+科研机构/科技企业"联合体为基本单元,已形成层次分明的矩阵。
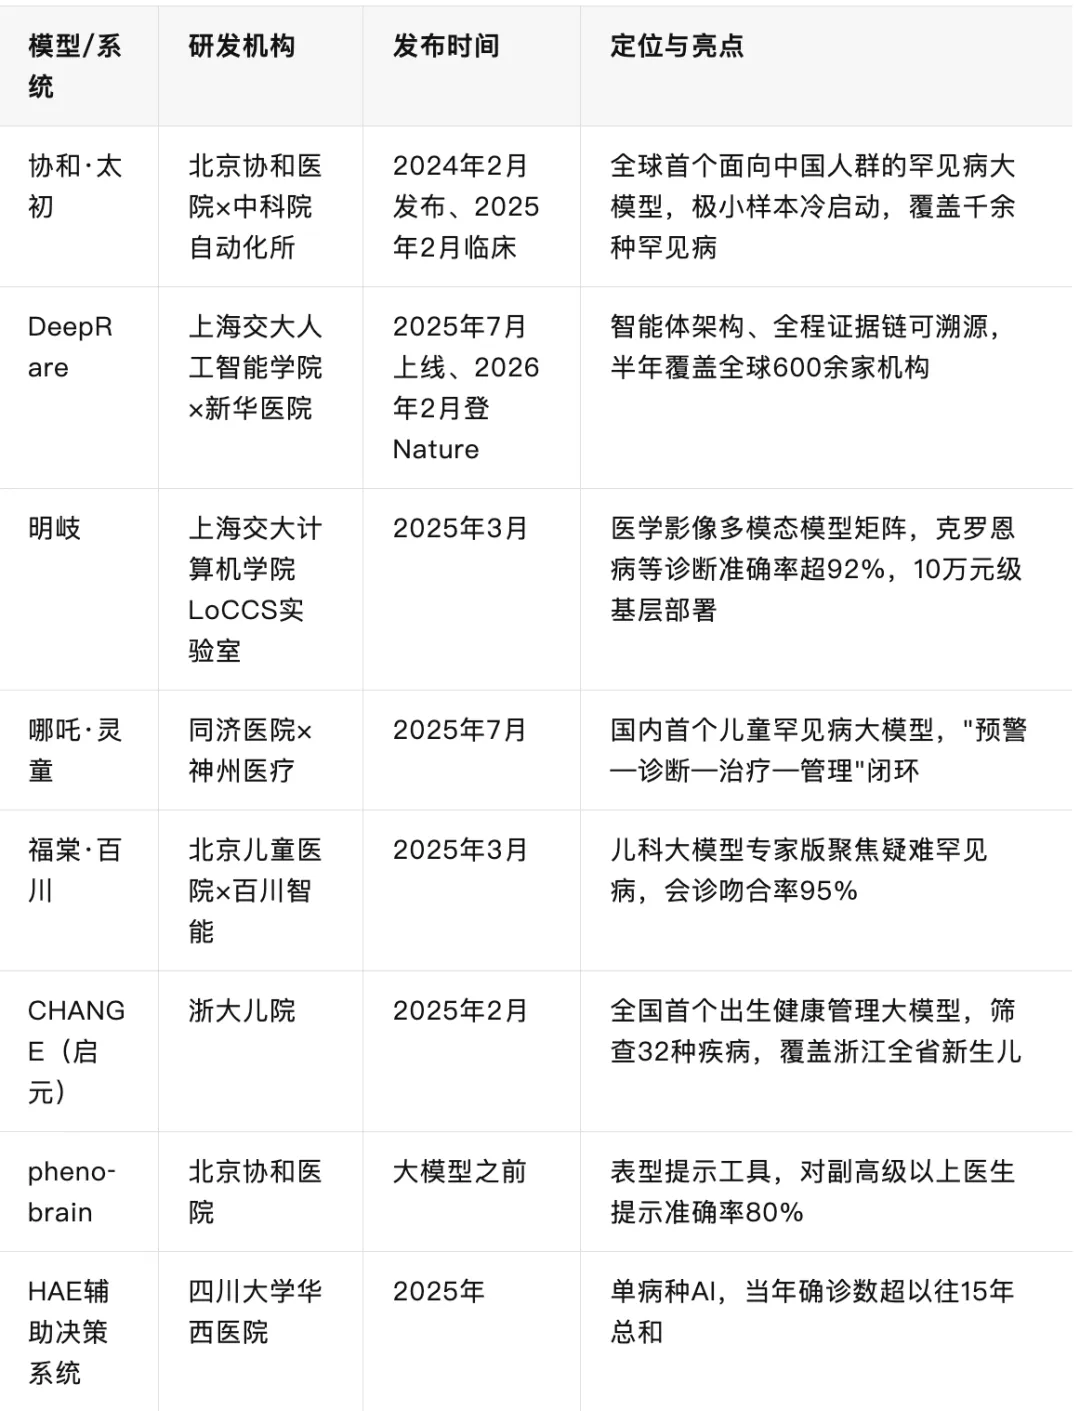
北京协和医院作为协作网国家级牵头医院,在大模型之前便已研发表型提示工具phenobrain,对副高级以上医生的罕见病诊断提示准确率达80%;2025年2月,协和与中科院自动化所联合研发的"协和·太初"罕见病大模型正式进入临床,依托千万级本土病例与专属基因数据训练,覆盖千余种罕见病的筛查、鉴别、诊断与个性化治疗方案制定。
上海交通大学则形成"双子星"布局:与附属新华医院联合研发的DeepRare上线半年即吸引全球600余家医疗科研机构、超千名专业用户注册使用;计算机学院研发的"明岐"影像大模型矩阵在湘雅三医院落地,聚焦消化道疑难病精准诊断。
(2)儿童罕见病是另一条密集产出的赛道。
华中科技大学同济医学院附属同济医院(同济儿童医院)与神州医疗于2025年7月发布国内首个儿童罕见病AI大模型"哪吒·灵童",构建覆盖"危重症预警—早期诊断—规范治疗—全程管理"的闭环;试运行3个月辅助诊断罕见病患儿127例,其中89例实现一周内确诊、较既往平均确诊时间缩短82%,15例疑难病例中模型的基因检测建议与专家组最终结论吻合度达100%。
国家儿童医学中心、北京儿童医院与百川智能等发布的"福棠·百川"儿科大模型(2025年3月)设专家版聚焦疑难罕见病,上岗一个月参与10余次多学科会诊,诊疗方案与专家会诊结果吻合率达95%。
浙江大学医学院附属儿童医院发布全国首个出生健康管理大模型CHANGE(中文名"启元"),融合心音听诊、基因与代谢筛查数据,为新生儿筛查心脏、基因、代谢等32种疾病;训练底座是浙江省新生儿疾病筛查中心自1999年以来累计的1,200余万例新生儿筛查记录,试点中复杂先天性心脏病诊断准确率达95.3%,2025年4月中旬起推广至浙江全省助产机构,让基层医院共享省级确诊能力。
(3)单病种与区域实践同样亮点纷呈。
四川大学华西医院研发的遗传性血管性水肿(HAE)AI辅助决策系统通过智能识别典型病症、预警高危发作、辅助分层管理,使该院2025年确诊的HAE病例数超过以往15年总和;该院还在研发多罕见病自动筛查模型并推进心血管罕见病AI智能体构建。
产学研合作方面,武田中国与复旦大学智能医学研究院2025年1月启动生成式AI"罕见病大语言模型与辅助筛查诊断数字化解决方案"项目,双方与复旦大学附属中山医院共同研发的心血管罕见病大模型已启动临床试点。
上海瑞金医院与华为发布的医疗大模型RuiPath也将垂体神经内分泌肿瘤等罕见病纳入辅助诊断范围。
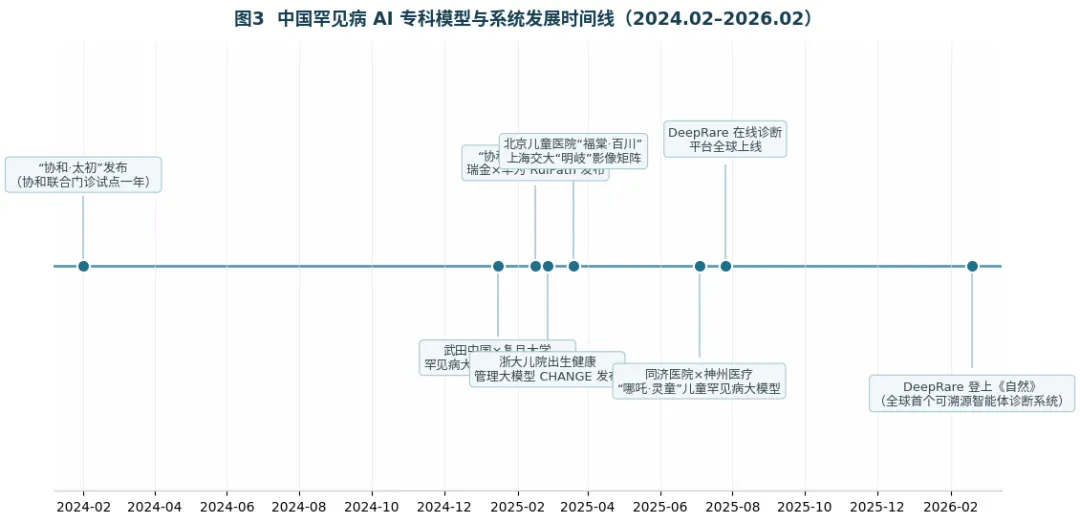
图3 中国罕见病AI专科模型发展时间线(来源:原报告整理)
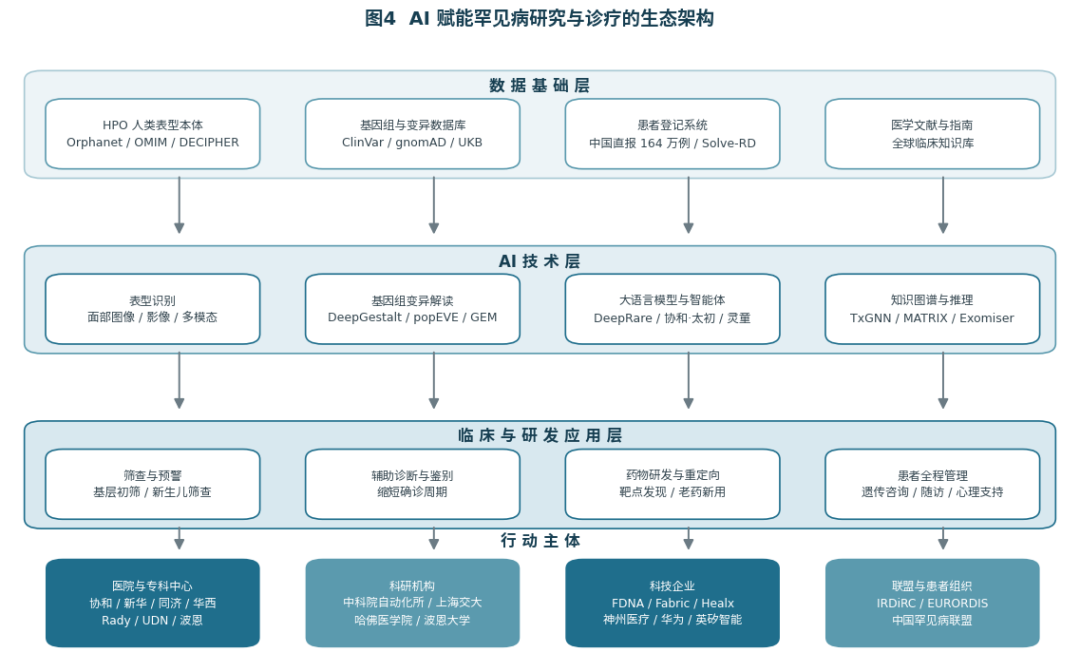
图4 AI赋能罕见病研究与诊疗的生态架构(来源:原报告整理)
3、中国主要罕见病AI模型与系统一览
五、专科大模型崛起:罕见病AI的"智能基座"如何炼成
1、"协和·太初":面向中国人群的罕见病基础模型样本
"协和·太初"是全球首个针对中国人群特征研发的罕见病大模型,其技术路径直面罕见病AI的三大死穴。(1)针对数据稀缺,团队放弃"海量数据训练"的常规路线,采用极小样本冷启动方式,仅需少量数据与医学知识融合即可实现覆盖全流程的辅助决策;(2)针对幻觉与可信度,模型构建了多维度可溯源知识库,通过整合权威数据、动态更新知识、增加溯源机制抑制"幻觉";(3)针对临床思维契合度,模型构建了"症状—检查—鉴别诊断"的渐进式推理链条,并引入DeepSeek-R1的深度推理能力作为智能基座,形成"临床使用—数据反馈—模型迭代"的自进化闭环。其训练底座包括协和百年积累的高质量病历、专家诊疗逻辑、权威医学知识库与科研教学数据集,实现从临床决策到药物临床试验管理的全流程智能辅助。
在应用节奏上,"协和·太初"2024年2月发布后先在北京协和医院罕见病联合门诊试点一年,2025年2月正式进入临床并优先向患者开放初诊咨询与预约功能——患者经多轮交互即可获得初步诊疗建议;二期规划则面向医生端,支持病历书写、基因解读、遗传咨询等功能。按照规划,该模型将接入协和罕见病联合门诊线上诊疗服务,并逐步推广至全国400余家罕见病诊疗协作网医院,其更深层的战略意图是以大模型支持基于国家直报数据的患者分层管理与双向转诊,让基层医生借人机协作开展高水平诊疗。第一财经的调研亦提示了需要持续观察的问题:小样本训练的性能边界、AI初筛的责任界定,以及推理逻辑能否真正比肩资深罕见病医生。
2、DeepRare:智能体范式的全球标杆与转化样本
如果说"协和·太初"代表了"知识+数据混合驱动"的专科基础模型路线,DeepRare则代表了"智能体编排"路线——它不训练一个端到端大模型,而是以"中枢—分身"架构调度知识检索、案例匹配、基因分析等多个专业智能体,通过可中断、可反思的推理循环生成带证据链的诊断报告。
这一设计的临床价值在于"白盒":每一个诊断结论都可溯源到具体文献与病例证据,直接回应了医疗AI的信任危机,也使其推理报告获得95.4%的医生认可度。其性能在RareBench、MyGene2、MIMIC-IV-Note罕见病子集及新华医院真实世界病例等多源基准上全面领先既有方法,在RareBench-MME上以78%/85%的Recall@1/Recall@3超出次优基线30/20个百分点;在新华医院的真实世界应用中,其首次诊断准确率达69.1%(作为对照,传统流程下罕见病首次就诊即确诊的比例极低)。
DeepRare的落地与转化速度同样具有标本意义:在线诊断平台2025年7月26日上线,半年内覆盖全球600余家机构;在新华医院内部署为全院罕见病诊疗"数字质控员";与头部基因检测机构合作以API实现临床解读报告自动化;团队同步启动"万人临床验证计划",依托18,000余例回顾性病例与2,000余例前瞻性多层级病例开展真实世界研究,并筹备发起"全球AI罕见病诊疗联盟"。产业化方面,团队已孵化"观壹智能"公司推动成果转化。
从"协和·太初"到DeepRare,中国罕见病大模型在两年内完成了从"跟跑"到在智能体诊断范式上"领跑"的跨越,《2026罕见病行业趋势观察报告》评价认为,中国已形成从"成人"到"儿童"、从"辅助诊断"到"全周期关爱"的罕见病AI完整布局。
3、全球视野下的罕见病专科模型谱系
将视野拉至全球,罕见病专科模型大致可归为四类技术范式,各有所长、互为补充。
(1)表型识别类模型(DeepGestalt、GestaltMatcher、明岐),胜在无创、低成本、可及性强,适合初筛。
(2)基因组解读类模型(Exomiser、Fabric GEM、popEVE),胜在分子确诊的权威性。
(3)语言/推理类专科大模型(协和·太初、哪吒·灵童、DeepRare),胜在全流程辅助与人机交互。
(4)知识图谱类基础模型,典型代表是哈佛医学院Marinka Zitnik团队2024年发表于《自然·医学》的TxGNN——这一图基础模型在覆盖17,080种疾病(其中92%无FDA批准药物)的医学知识图谱上预训练,可对无药疾病进行零样本药物重定向预测,并附带多跳可解释路径。
这一谱系揭示出罕见病专科模型的两条演进主线:
技术上,从单点工具走向"多模态输入—智能体推理—全流程覆盖"的系统级模型;
应用上,从服务顶尖中心走向赋能基层——明岐把部署成本降到10万元量级、DeepRare凭纯表型输入即可初筛、"协和·太初"与"哪吒·灵童"均明确以基层能力提升为目标,专科模型正在成为分级诊疗体系中"可复制的专家经验"。
六、药物研发:AI改写"无药可医"的经济学
1、药物重定向:被AI重新定价的"存量药物"
罕见病药物研发的死结在于经济学:患者池小、研发成本高企,传统"一款新药十年、二十亿美元"的模式在绝大多数罕见病上无法成立,全球超过3亿患者所患疾病没有可用疗法。
(1)AI药物重定向(老药新用)因此成为破局主线。
美国非营利机构Every Cure由靠"老药"自救成功的Castleman病患者、宾夕法尼亚大学医师David Fajgenbaum创立,其MATRIX平台用AI与生物医学知识图谱对"所有获批药物×所有疾病"进行全组合评分,覆盖超过6,600万个药物—疾病对;该平台获美国卫生高级研究计划局(ARPA-H)三期4,830万美元合同支持,2026年2月再获最高7,600万美元资助,用于推进至少20个重定向机会的临床前研究和10项临床试验;此前团队已推动14种重定向药物成为5种罕见病的有效疗法,包括西罗莫司治疗Castleman病、以及AI建议的联合方案挽救POEMS综合征危重患者等案例,并与Google Cloud合作引入Gemini大模型增强预测能力。
(2)学术界的“图基础模型”则在把重定向推向"零样本"时代。
TxGNN在覆盖17,080种疾病的知识图谱上预训练,其中92%的疾病没有任何FDA批准药物,模型借助度量学习把"有药可治疾病"的知识迁移到无药疾病,无需额外训练即可给出候选药物与可解释的多跳推理路径,其预测与大型医疗系统中医生的超说明书用药记录高度吻合。
英国剑桥的Healx公司则以Healnet平台专注罕见病重定向,其候选药HLX-1502获FDA孤儿药与罕见儿科疾病认定及快速通道资格,已进入神经纤维瘤病I型(NF1)II期临床,并与赛诺菲合作挖掘其搁置资产的新适应症。
2、从靶点发现到分子设计:中国AI制药的罕见病答卷
中国AI制药企业在罕见病领域已从概念走向临床。
2026年7月7日,英矽智能(Insilico Medicine,港交所03696)宣布其AI药物rentosertib(代号INS018_055)正式启动III期临床试验——这是全球首个从靶点发现到分子设计全程由AI主导的药物,走到了上市前的最后一步。该药治疗特发性肺纤维化(IPF,一种病因不明的致命性肺部疾病,已纳入我国第二批罕见病目录):AI平台从海量组学数据中挖出全新靶点(TNIK),再生成设计分子,从靶点确认到临床前候选化合物仅用时约18个月、耗资数百万美元,约为传统路径三分之一的时间与十分之一的成本,2023年获FDA孤儿药资格。2025年6月,其IIa期结果正式发表于《自然·医学》(Nature Medicine):71例患者中,每日60mg组12周后肺功能(用力肺活量FVC)平均改善98.4毫升,安慰剂组反而下降20.3毫升。正在进行的III期计划在全国47家中心入组320名患者、给药52周,由北京协和医院徐作军教授牵头,钟南山院士联合牵头,预计2029年前后读出数据。晶泰科技的"AI+机器人实验室"体系则通过与溪砾科技合作,推动小分子调控RNA疗法RTX-117获得NMPA罕见病适应症的临床审批;其与希格生科联合发现的弥漫性胃癌靶向药SIGX1094也已获FDA孤儿药认定。
需要清醒认识的是,AI缩短的是"发现"环节,而非生物学验证本身——业内普遍将临床II期视为AI药物真正的"死亡之谷",全球尚无AI主导研发的药物获批上市。
但对罕见病而言,AI的价值不必等到"终极大考":仅是把重定向候选的发现成本降低一到两个数量级、把临床试验受试者招募从"大海捞针"变为精准画像(如按NF1基因突变快速筛选潜在受试者),就足以改变大量"无利可图"病种的研发可行性。
七、冷思考:数据、偏见、幻觉与治理
1、数据稀缺与质量仍是第一约束。
罕见病单病种病例少、表型异质性高,小样本训练的性能天花板客观存在;中国UPWARDS国家级罕见病基因组诊断项目对42,703个家庭的分析显示总体诊断率29.58%(处于国际20%–50%区间),仍有70%以上病例未确诊。团队指出非编码区变异研究不足、WGS应用比例偏低(22.61%)等数据短板,正计划以多组学整合与AI辅助解读提升诊断率。数据孤岛同样棘手——这也是联邦学习等隐私计算技术与国家级可信数据空间被寄予厚望的原因;CHANGE依托浙江全省统一的新生儿筛查网络实现基层与三甲数据贯通,则提供了另一种"制度先行"的解题思路。
2、算法偏见可能加剧而非缓解健康不平等。
面部识别模型的训练数据以高加索人种为主,已有研究(针对唐氏综合征的面容识别)显示,Face2Gene在比利时白人儿童中的识别率为80%,而在刚果黑人儿童中仅为37%;族裔、年龄、性别分布不均的数据集会在AI时代被放大为诊断可及性差距。这恰恰凸显"协和·太初"等基于中国人群数据训练模型的必要性,也提示全球模型需要更公平的采样与验证框架。
3、幻觉、责任与监管框架正在成形。
大模型的"一本正经地胡说八道"在医疗场景代价高昂,可溯源证据链(DeepRare)、可解释推理路径(TxGNN Explainer)、与专家会诊对齐验证(福棠·百川95%吻合率)成为三类主流的信任工程方案。
监管层面,欧盟GDPR与《人工智能法案》对医疗AI与面部基因数据设定了严格合规要求,美国HIPAA框架下面部影像的存储与再利用亦存争议;中国《关于促进和规范"人工智能+医疗卫生"应用发展的实施意见》则以"政府引导、多方参与、创新驱动、安全可控"为原则,既设定2027/2030发展目标,也强调标准规范体系建设。此外,面部图像本质上携带遗传信息,用政府身份照片库做大人群罕见病筛查在技术上行得通、在伦理上仍存重大争议,需要知情同意、数据最小化与用途限定等制度护栏。
八、未来展望:从"确诊难"到"全周期智能守护"
未来五年,AI赋能罕见病研究大概率沿四条主线深化。
1、诊断前移:以BeginNGS(500余种疾病的新生儿基因组+AI筛查)、CHANGE(心音+基因+代谢的新生儿多模态预测)为代表,罕见病发现的时点正从"症状出现后辗转数年"前移至新生儿期乃至产前。
2、智能体化与全流程覆盖:DeepRare的"中枢—分身"架构与"哪吒·灵童"的"预警—诊断—治疗—管理"闭环预示,单点辅助诊断工具将被覆盖遗传咨询、用药指导、临床试验匹配、心理支持的全周期智能体取代。
3、全球网络化:DeepRare团队筹备的"全球AI罕见病诊疗联盟"、Every Cure的开源全组合评分、IRDiRC的联邦匹配网络,指向一个"任何医生都能调用全球罕见病知识"的协同格局。
4、研发范式重构:当TxGNN类零样本模型与MATRIX类全组合平台持续成熟,"为超罕见病逐个立项研发"或将让位于"按需计算、批量验证"的新范式,罕见病药物研发的供给曲线有望被整体右移。
对全球3亿"医学孤儿"而言,AI不会替代罕见病医生,但正在把稀缺的专家经验转化为可复制的系统能力。让基层医院也能初筛,让存量基因组数据再获诊断机会,让无药可医的疾病重新进入药物经济学可行域。中国以政策体系、数据规模与"医院—科研院所—企业"联合体的组织优势,在罕见病专科模型赛道形成了与欧美并跑乃至部分领跑的格局;而这场竞赛的终点不是技术排行榜,而是每一个家庭确诊等待时间的真实缩短。
💬 互动:你觉得AI会先在哪个环节真正跑通?
A. 诊断——把"平均4.7年"的确诊马拉松缩到4周,DeepRare们已经在路上;B. 药物研发——rentosertib已进III期,让"无药可医"变成"有病可医"。
评论区聊聊你的判断。如果这篇全景梳理对你有用,点个关注——「AI医疗」持续追踪AI与生命科学交叉前沿。
信源清单(按章节分组)
摘要与第一章
- Norstella: Rare? Actually Not Rare(norstella.com/insight/rare-actually-not-rare)
- 红杉汇(微信公众号)、Propelx: Healx罕见病药物研发分析
- EURORDIS Rare Barometer调查(eurordis.org/survey-reveals-lengthy-diagnostic-delays)
- 《2020中国罕见病综合社会调研》(sanyfoundation.org);科学网;梅斯医学MedSci
- 弗若斯特沙利文《罕见病与AI交叉领域研究综述》(frostchina.com)
第二章
- 中国医疗器械网(DeepGestalt);Gurovich et al., Nature Medicine 2019(arXiv:1801.07637)
- Hsieh et al., Nature Genetics(GestaltMatcher,s41588-021-01010-x);環球生技月刊(TRANSLATE NAMSE)
- 上海交通大学新闻学术网("明岐"发布,news.sjtu.edu.cn/jdyw/20250331/208610.html);新华社、人民网、科学网相关报道
- Turro et al., NEJM 2020(英国10万人基因组计划先导研究);Global Genes(Fabric GEM);Rady儿童基因组医学研究院
- popEVE, Nature Genetics 2025(s41588-025-02400-1);ASHG 2025年会摘要集(变异解读荟萃分析)
- UDN大模型评估,JAMA Network Open 2025(jamanetwork.com/journals/jamanetworkopen/fullarticle/2837941)
- DeepRare, Nature 2026(s41586-025-10097-9);澎湃新闻(Nature同期评论)
第三章
- IRDiRC愿景声明,Nature(gt201729);Solve-RD,Nature Medicine 2024(s41591-024-03420-w)
- MedSci(ERDERA);梅斯医学MedSci(UDN);Genomics Education Programme(10万人基因组计划)
- Rady儿童基因组医学研究院;Frontiers in Public Health 2025(iHope,fpubh.2025.1706653)
- 罕见病信息网(HPO/Orphanet/OMIM/DECIPHER);武汉大学中南医院学报(Llama表型标准化)
第四章
- 新华网(两批罕见病目录);中国医疗器械网(协作网419家);新京报(直报系统164万例)
- 中国能源报/人民日报海外版(医保支付86亿元);国家医保局《2025年国家医保药品目录及首版商保创新药目录》(nhsa.gov.cn,2025年12月7日发布、2026年1月1日执行)
- 中国医院协会信息专业委员会(五部门实施意见);东方财富网(《2026罕见病行业趋势观察报告》)
- 东方财富网股吧(协和phenobrain/太初);中国科技网(DeepRare 600余家机构)
- 微信公众平台(哪吒·灵童127例/89例/82%);微信公众号AI学点啥(福棠·百川95%)
- 中新网、杭州网(CHANGE启元大模型:32种疾病、1200万病例数据、副高级以上水平);浙大儿院学报(zdygb.zju.edu.cn)
- 四川在线(华西HAE系统);法治周末网(武田×复旦、瑞金RuiPath)
第五章
- 新浪财经(协和·太初技术路线两则);Readhub;微信公众号"罕见病";第一财经(东方财富网股吧转载)
- 新华网(DeepRare 95.4%认可度、真实世界数据);上海交通大学医学院附属新华医院(万人临床验证计划、69.1%)
- 新浪财经(观壹智能);东方财富网(《2026罕见病行业趋势观察报告》评价)
- TxGNN, Nature Medicine 2024(s41591-024-03233-x);医药魔方(明岐部署成本)
第六章
- Morningstar/PR Newswire(Every Cure ARPA-H合同及2026年2月追加资助);Cure HSPB8(重定向案例库)
- TxGNN, Nature Medicine 2024;Propelx(Healx/HLX-1502)
- 英矽智能官网及公告(rentosertib III期启动,2026年7月7日);Nature Medicine 2025(IIa期结果);医药魔方(IIa期早期披露)
- 晶泰科技官网(RTX-117、SIGX1094);微信公众号"梅斯AI情报社"
第七章
- 华大基因(UPWARDS项目42,703家庭、29.58%)
- MDPI AI(Face2Gene族裔偏差、监管与伦理三则);中国科技网(信任工程方案)
第八章
- Frontiers in Public Health 2025;中国科技网;新华网(全球AI罕见病诊疗联盟);Nature系列论文